Map的实现原理
golang 的 map 底层是哈希表查找,平均查找效率是 O(1),最差是 O(N)
go源码
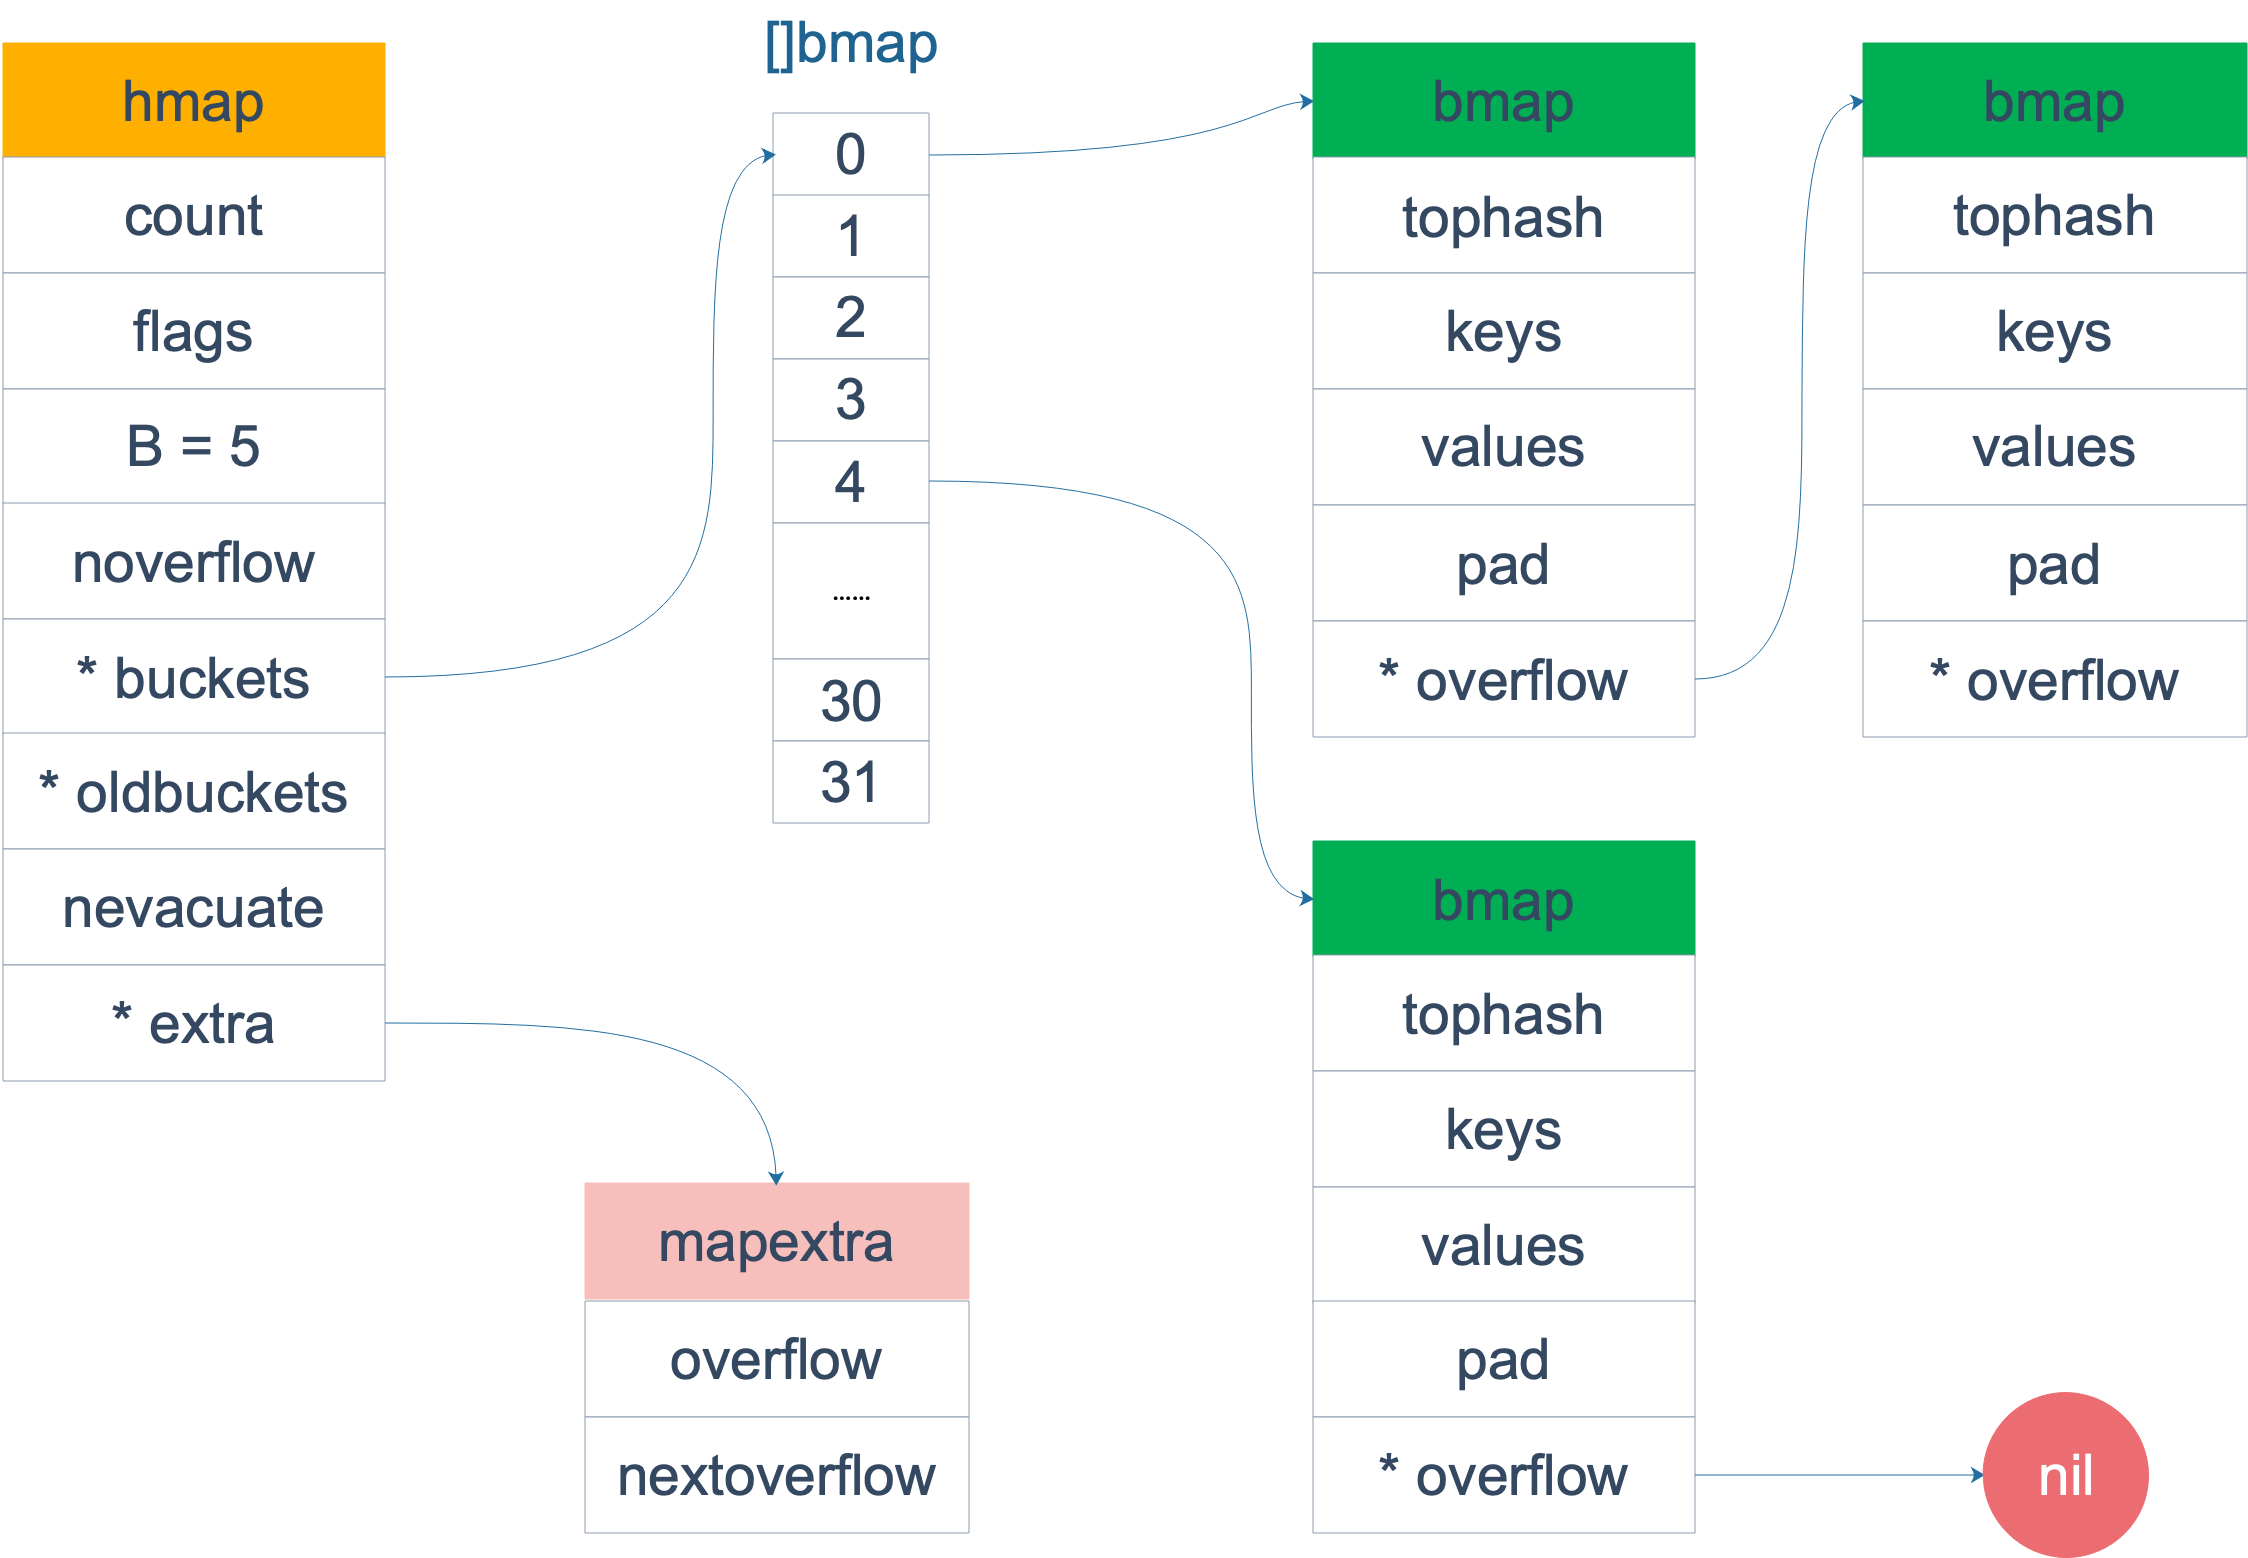
在源码中,表示 map 的结构体是 hmap,它是 hashmap 的“缩写”:
// A header for a Go map.
type hmap struct {
	count     int // 元素个数,调用 len(map) 时,直接返回此值
	flags     uint8
	B         uint8  // buckets 的对数 log_2
	noverflow uint16 // overflow 的 bucket 近似数,做扩容决策II的判断
	hash0     uint32 // hash seed

	buckets    unsafe.Pointer // 指向 buckets 数组,大小为 2^B,如果元素个数为0,就为 nil
	oldbuckets unsafe.Pointer // 指向旧桶数组的指针(用于扩容时的临时存储)
	nevacuate  uintptr        // 指示扩容进度,小于此地址的 buckets 迁移完成

	extra *mapextra // optional fields
}
mapextra 结构体包含了与哈希表相关的额外信息,其定义如下:
type mapextra struct {
    overflow     *[]*bmap // 溢出桶的指针数组
    oldoverflow  *[]*bmap // 旧溢出桶的指针数组(用于扩容)
    nextOverflow *bmap     // 下一个要分配的溢出桶
}
buckets 是一个指针,最终它指向的是一个结构体:
type bmap struct {
    topbits  [8]uint8    // 存储每个键的哈希值的高 8 位
    keys     [8]keytype  // 存储 8 个键
    values   [8]valuetype // 存储 8 个值
    pad      uintptr     // 填充字段,用于内存对齐
    overflow uintptr     // 指向下一个溢出桶的指针
}
- topbits [8]uint8 存储每个键的哈希值的高 8 位(称为 tophash),用于快速判断某个键是否可能存在于当前桶中。如果 topbits[i] 与某个键的哈希值高 8 位匹配,则进一步检查键是否相等。
- 键和值分开存储,以减少内存对齐带来的填充(padding),节省内存。
- 当一个桶中的键值对数量超过 8 时,会通过 overflow 指针链接到一个新的桶,形成链表结构。
创建Map
从语法层面上来说,创建 map 很简单:
ageMp := make(map[string]int)
// 指定 map 长度
ageMp := make(map[string]int, 8)

// ageMp 为 nil,不能向其添加元素,会直接panic
var ageMp map[string]int
实际上底层调用的是 makemap 函数,主要做的工作就是初始化 hmap 结构体的各种字段,例如计算 B 的大小,设置哈希种子 hash0 等等。
func makemap(t *maptype, hint int64, h *hmap, bucket unsafe.Pointer) *hmap {
	// 省略各种条件检查...

	// 找到一个 B,使得 map 的装载因子在正常范围内
	B := uint8(0)
	for ; overLoadFactor(hint, B); B++ {
	}

	// 初始化 hash table
	// 如果 B 等于 0,那么 buckets 就会在赋值的时候再分配
	// 如果长度比较大,分配内存会花费长一点
	buckets := bucket
	var extra *mapextra
	if B != 0 {
		var nextOverflow *bmap
		buckets, nextOverflow = makeBucketArray(t, B)
		if nextOverflow != nil {
			extra = new(mapextra)
			extra.nextOverflow = nextOverflow
		}
	}

	// 初始化 hamp
	if h == nil {
		h = (*hmap)(newobject(t.hmap))
	}
	h.count = 0
	h.B = B
	h.extra = extra
	h.flags = 0
	h.hash0 = fastrand() // hash0 是一个随机值,用于哈希计算。每次初始化 map 时,hash0 都会不同,以防止哈希碰撞攻击。
	h.buckets = buckets
	h.oldbuckets = nil
	h.nevacuate = 0
	h.noverflow = 0

	return h
}
注意,这个函数返回的结果:*hmap,它是一个指针。
key定位
不同类型 key 根据对应的哈希函数以及 hmap.hash0 计算哈希值 hash
hash 低 B 位确定桶索引 bucketIndex := hash & (1<<B - 1)
hash 高 8 位找到此 key 在 bucket 中的位置,这是在寻找已有的 key。最开始桶内还没有 key,新加入的 key 会找到第一个空位,放入。
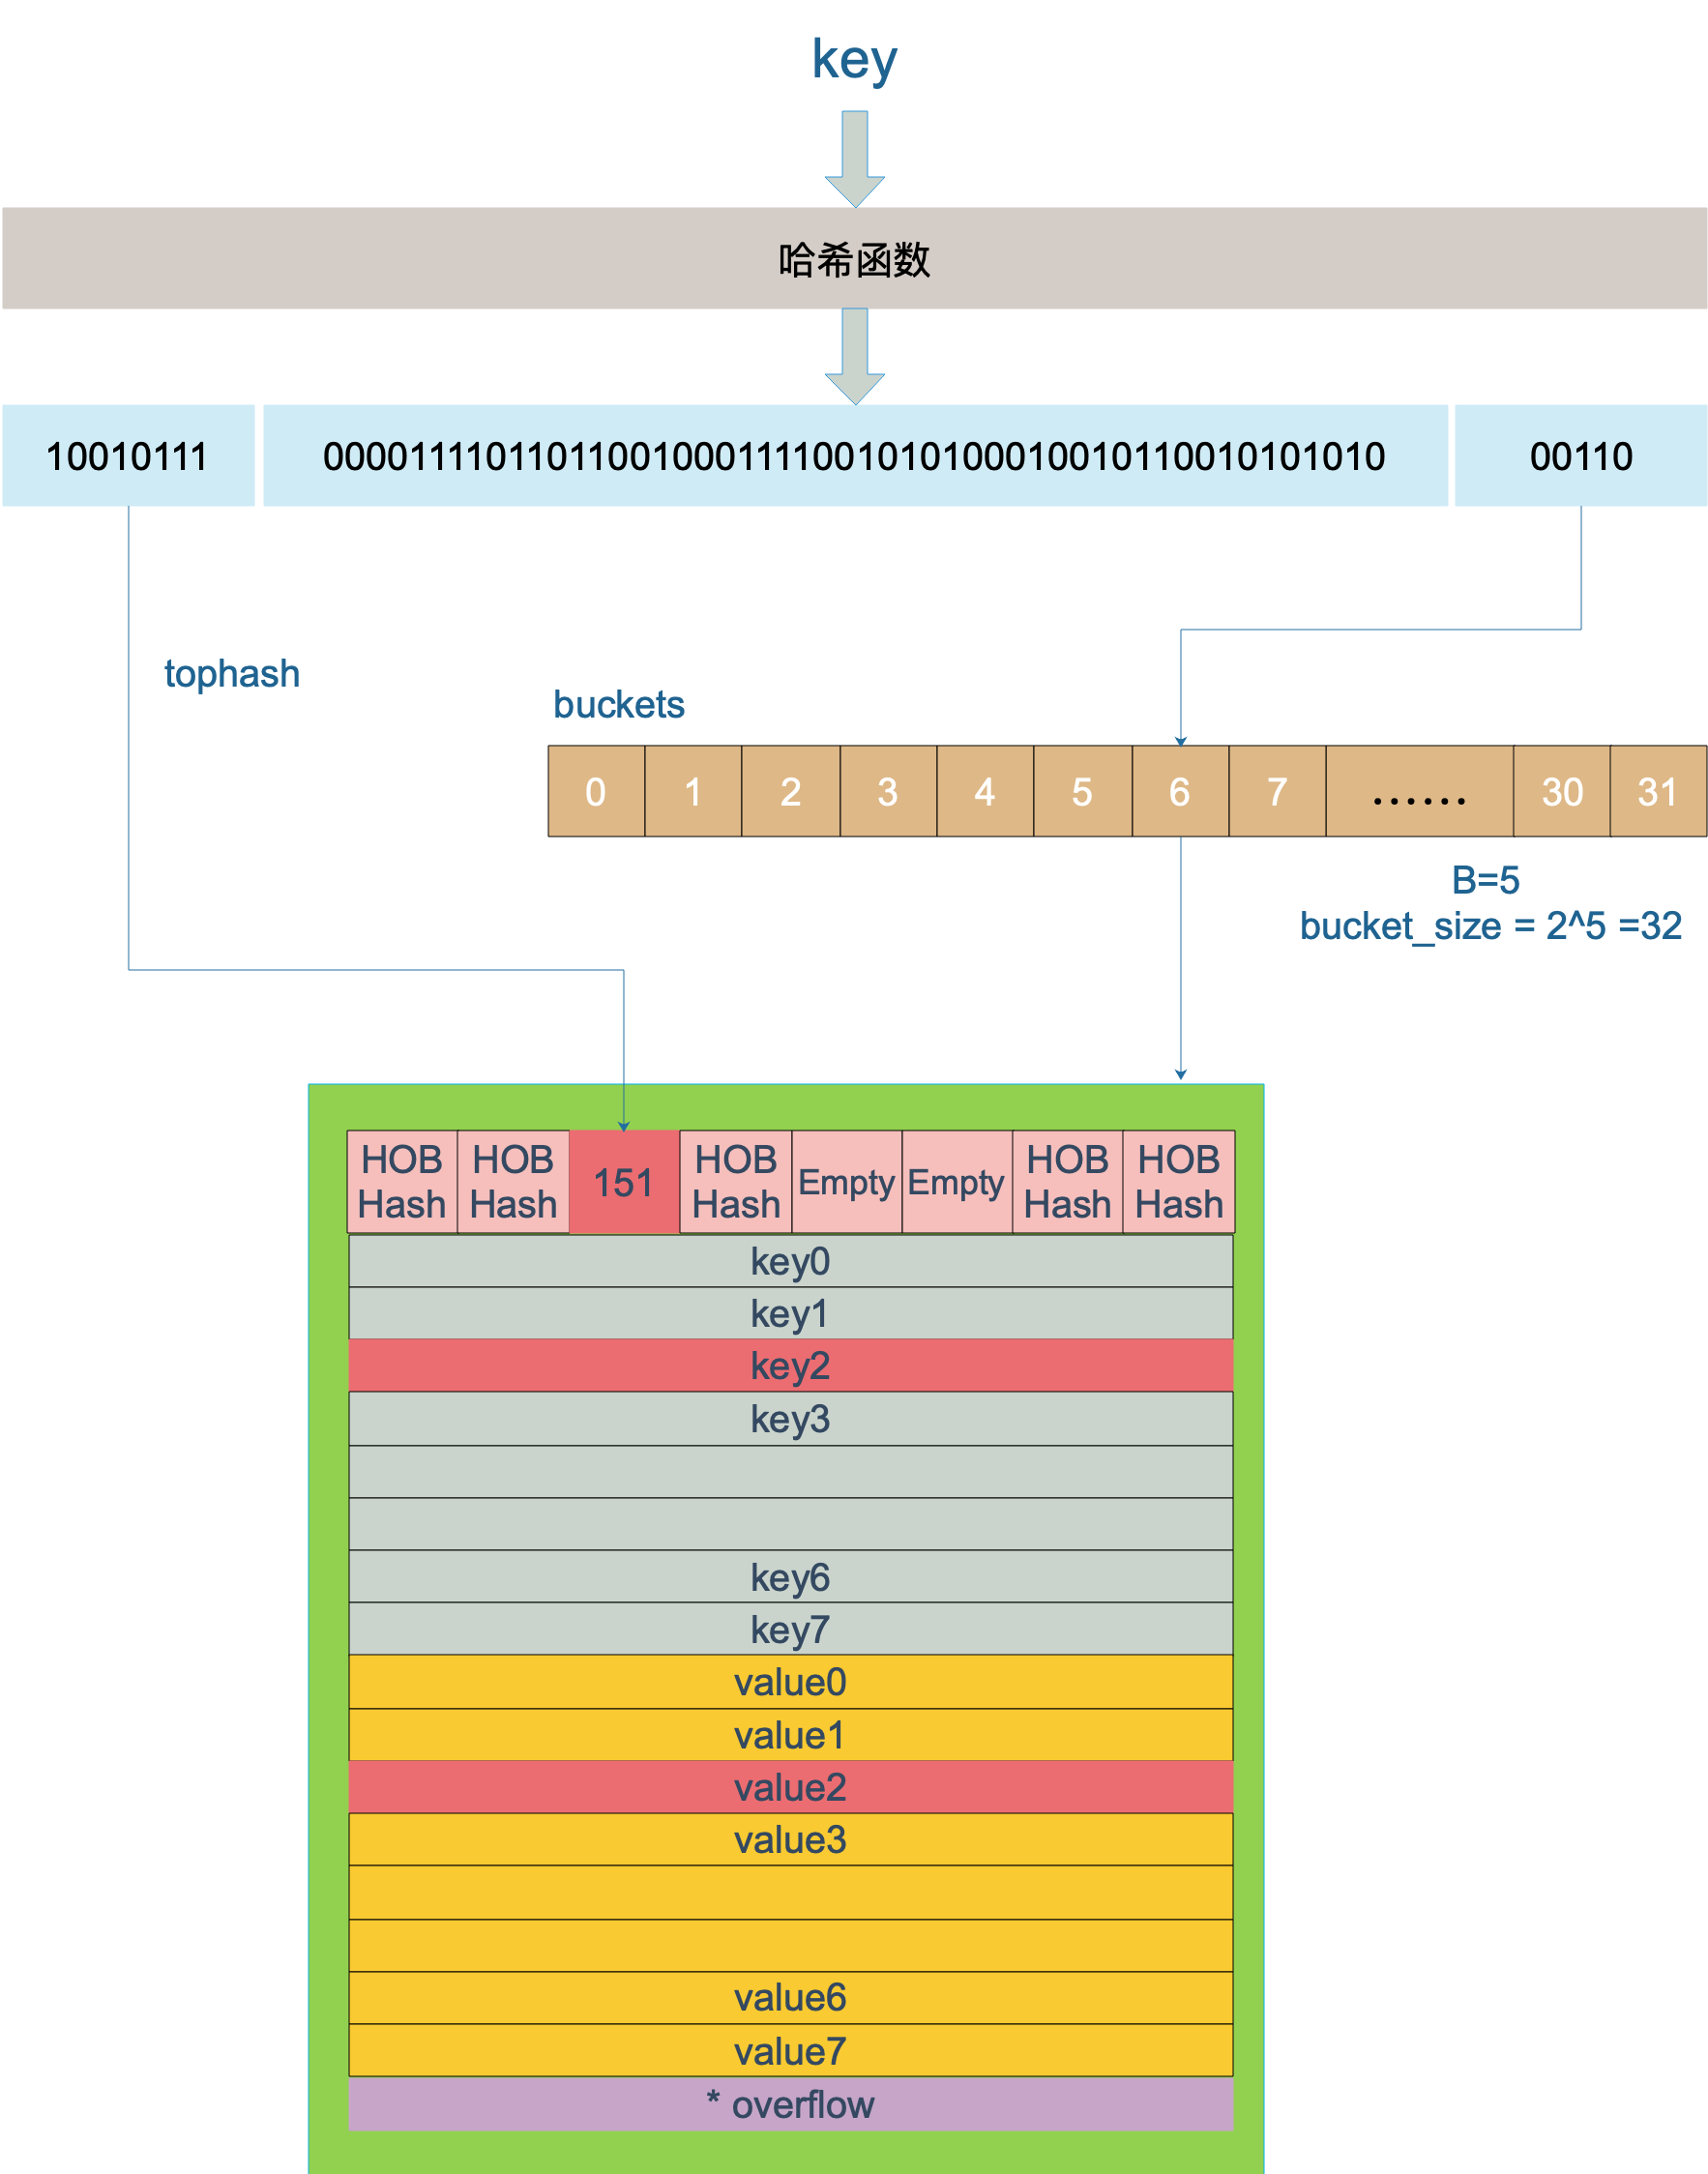
再说一下 minTopHash,当一个 cell 的 tophash 值小于 minTopHash 时,标志这个 cell 的迁移状态。因为这个状态值是放在 tophash 数组里,为了和正常的哈希值区分开,会给 key 计算出来的哈希值一个增量:minTopHash。这样就能区分正常的 top hash 值和表示状态的哈希值。
// 空的 cell,也是初始时 bucket 的状态
empty          = 0
// 空的 cell,表示 cell 已经被迁移到新的 bucket
evacuatedEmpty = 1
// key,value 已经搬迁完毕,但是 key 都在新 bucket 前半部分,
// 后面扩容部分会再讲到。
evacuatedX     = 2
// 同上,key 在后半部分
evacuatedY     = 3
// tophash 的最小正常值
minTopHash     = 4
Map赋值/更新
实际上插入或修改 key 的语法是一样的,只不过前者操作的 key 在 map 中不存在,而后者操作的 key 存在 map 中。
mapassign 有一个系列的函数,根据 key 类型的不同,编译器会将其优化为相应的“快速函数”。
| key | 类型 |
|---|---|
| uint32 | mapassign_fast32(t *maptype, h *hmap, key uint32) |
| uint64 | mapassign_fast64(t *maptype, h *hmap, key uint64) |
| string | mapassign_faststr(t *maptype, h *hmap, ky string) |
源码大体和之前讲的类似,核心还是一个双层循环,外层遍历 bucket 和它的 overflow bucket,内层遍历整个 bucket 的各个 cell。
针对这个过程提几点重要的细节:
- 函数首先会检查 map 的标志位 flags。如果 flags 的写标志位此时被置 1 了,说明有其他协程在执行“写”操作,进而导致程序 panic。
- 我们知道扩容是渐进式的,如果 map 处在扩容的过程中,那么当 key 定位到了某个 bucket 后,需要确保这个 bucket 对应的老 bucket 完成了迁移过程。即老 bucket 里的 key 都要迁移到新的 bucket 中来(分裂到 2 个新 bucket),才能在新的 bucket 中进行插入或者更新的操作。
- 在循环的过程中,如果在 map 没有找到 key 的存在,也就是说原来 map 中没有此 key,这意味着插入新 key。那最终 key 的安置地址就是第一次发现的“空位”(tophash 是 empty)。
- 如果这个 bucket 的 8 个 key 都已经放置满了,那在跳出循环后,发现 inserti 和 insertk 都是空,这时候需要在 bucket 后面挂上 overflow bucket。当然,也有可能是在 overflow bucket 后面再挂上一个 overflow bucket。这就说明,太多 key hash 到了此 bucket。
- 在正式安置 key 之前,还要检查 map 的状态,看它是否需要进行扩容。如果满足扩容的条件,就主动触发一次扩容操作。
- 最后,会更新 map 相关的值,如果是插入新 key,map 的元素数量字段 count 值会加 1;在函数之初设置的 hashWriting 写标志flag清零。
func mapassign(t *maptype, h *hmap, key unsafe.Pointer) unsafe.Pointer {
	if h == nil {
		panic(plainError("assignment to entry in nil map"))
	}
	...
	if h.flags&hashWriting != 0 {
		fatal("concurrent map writes")
	}
	hash := t.Hasher(key, uintptr(h.hash0))

	// Set hashWriting after calling t.hasher, since t.hasher may panic,
	// in which case we have not actually done a write.
	h.flags ^= hashWriting

	if h.buckets == nil {
		h.buckets = newobject(t.Bucket) // newarray(t.Bucket, 1)
	}

again:
	bucket := hash & bucketMask(h.B)
	if h.growing() {
		growWork(t, h, bucket)
	}
	b := (*bmap)(add(h.buckets, bucket*uintptr(t.BucketSize)))
	top := tophash(hash)

	var inserti *uint8
	var insertk unsafe.Pointer
	var elem unsafe.Pointer
bucketloop:
	for {
		for i := uintptr(0); i < abi.OldMapBucketCount; i++ {
			if b.tophash[i] != top {
				if isEmpty(b.tophash[i]) && inserti == nil {
					inserti = &b.tophash[i]
					insertk = add(unsafe.Pointer(b), dataOffset+i*uintptr(t.KeySize))
					elem = add(unsafe.Pointer(b), dataOffset+abi.OldMapBucketCount*uintptr(t.KeySize)+i*uintptr(t.ValueSize))
				}
				if b.tophash[i] == emptyRest {
					break bucketloop
				}
				continue
			}
			k := add(unsafe.Pointer(b), dataOffset+i*uintptr(t.KeySize))
			if t.IndirectKey() {
				k = *((*unsafe.Pointer)(k))
			}
			if !t.Key.Equal(key, k) {
				continue
			}
			// already have a mapping for key. Update it.
			if t.NeedKeyUpdate() {
				typedmemmove(t.Key, k, key)
			}
			elem = add(unsafe.Pointer(b), dataOffset+abi.OldMapBucketCount*uintptr(t.KeySize)+i*uintptr(t.ValueSize))
			goto done
		}
		ovf := b.overflow(t)
		if ovf == nil {
			break
		}
		b = ovf
	}

	// Did not find mapping for key. Allocate new cell & add entry.

	// If we hit the max load factor or we have too many overflow buckets,
	// and we're not already in the middle of growing, start growing.
	if !h.growing() && (overLoadFactor(h.count+1, h.B) || tooManyOverflowBuckets(h.noverflow, h.B)) {
		hashGrow(t, h)
		goto again // Growing the table invalidates everything, so try again
	}

	if inserti == nil {
		// The current bucket and all the overflow buckets connected to it are full, allocate a new one.
		newb := h.newoverflow(t, b)
		inserti = &newb.tophash[0]
		insertk = add(unsafe.Pointer(newb), dataOffset)
		elem = add(insertk, abi.OldMapBucketCount*uintptr(t.KeySize))
	}

	// store new key/elem at insert position
	if t.IndirectKey() {
		kmem := newobject(t.Key)
		*(*unsafe.Pointer)(insertk) = kmem
		insertk = kmem
	}
	if t.IndirectElem() {
		vmem := newobject(t.Elem)
		*(*unsafe.Pointer)(elem) = vmem
	}
	typedmemmove(t.Key, insertk, key)
	*inserti = top
	h.count++

done:
	if h.flags&hashWriting == 0 {
		fatal("concurrent map writes")
	}
	h.flags &^= hashWriting
	if t.IndirectElem() {
		elem = *((*unsafe.Pointer)(elem))
	}
	return elem
}
Map删除
删除操作同样是两层循环,核心还是找到 key 的具体位置。寻找过程都是类似的,在 bucket 中挨个 cell 寻找。 找到对应位置后,对 key 或者 value 进行“清零”操作:
- 对 key 清零
- 对 value 清零
- 将 count 值减 1,将对应位置的 tophash 值置成 Empty
Map扩容
随着向 map 中添加的 key 越来越多,key 发生碰撞的概率也越来越大。bucket 中的 8 个 cell 会被逐渐塞满,查找、插入、删除 key 的效率也会越来越低。最理想的情况是一个 bucket 只装一个 key,这样,就能达到 O(1) 的效率,但这样空间消耗太大,用空间换时间的代价太高。
因此,需要有一个指标来衡量前面描述的情况,这就是装载因子loadFactor := count / (2^B)
count 就是 map 的元素个数,2^B 表示 bucket 数量。
扩容时机
再来说触发 map 扩容的时机:在向 map 插入(mapassign) 新 key 的时候,会进行条件检测,符合下面这 2 个条件其中之一,就会触发扩容:
- 装载因子超过阈值,源码里定义的阈值是 6.5。
- overflow 的 bucket 数量过多:当 B 小于 15,也就是 bucket 总数 2^B 小于 2^15 时,如果 overflow 的 bucket 数量超过 2^B;当 B >= 15,也就是 bucket 总数 2^B 大于等于 2^15,如果 overflow 的 bucket 数量超过 2^15。
if !h.growing() && (overLoadFactor(int64(h.count), h.B) || tooManyOverflowBuckets(h.noverflow, h.B)) {
	hashGrow(t, h)
}
第 1 点:我们知道,每个 bucket 有 8 个空位,在没有溢出,且所有的桶都装满了的情况下,装载因子算出来的结果是 8。因此当装载因子超过 6.5 时,表明很多 bucket 都快要装满了,查找效率和插入效率都变低了。在这个时候进行扩容是有必要的。
扩容策略:将 B 加 1,bucket 最大数量(2^B)直接变成原来 bucket 数量的 2 倍。于是,就有新老 bucket 了。注意,这时候元素都在老 bucket 里,还没迁移到新的 bucket 来。而且,新 bucket 只是最大数量变为原来最大数量(2^B)的 2 倍(2^B * 2)
第 2 点:是对第 1 点的补充。就是说在装载因子比较小的情况下,这时候 map 的查找和插入效率也很低,而第 1 点识别不出来这种情况。表面现象就是计算装载因子的分子比较小,即 map 里元素总数少,但是 bucket 数量多(真实分配的 bucket 数量多,包括大量的 overflow bucket)。 不难想像造成这种情况的原因:不停地插入、删除元素。先插入很多元素,导致创建了很多 bucket,但是装载因子达不到第 1 点的临界值,未触发扩容来缓解这种情况。之后,删除元素降低元素总数量,再插入很多元素,导致创建很多的 overflow bucket,但就是不会触犯第 1 点的规定,你能拿我怎么办?overflow bucket 数量太多,导致 key 会很分散,查找插入效率低得吓人,因此出台第 2 点规定。这就像是一座空城,房子很多,但是住户很少,都分散了,找起人来很困难。
扩容策略:解决办法就是开辟一个新 bucket 空间,将老 bucket 中的元素移动到新 bucket,使得同一个 bucket 中的 key 排列地更紧密。这样,原来,在 overflow bucket 中的 key 可以移动到 bucket 中来。结果是节省空间,提高 bucket 利用率,map 的查找和插入效率自然就会提升。
渐进式扩容
再来看一下扩容具体是怎么做的。由于 map 扩容需要将原有的 key/value 重新搬迁到新的内存地址,如果有大量的 key/value 需要搬迁,会非常影响性能。因此 Go map 的扩容采取了一种称为“渐进式”地方式,原有的 key 并不会一次性搬迁完毕,每次最多只会搬迁 2个bucket。
上面说的 hashGrow() 函数实际上并没有真正地“搬迁”,它只是分配好了新的 buckets,并将老的 buckets 挂到了 oldbuckets 字段上。真正搬迁 buckets 的动作在 growWork() 函数中,而调用 growWork() 函数的动作是在 mapassign 和 mapdelete 函数中。也就是插入或修改、删除 key 的时候,都会尝试进行搬迁 buckets 的工作。先检查 oldbuckets 是否搬迁完毕,具体来说就是检查 oldbuckets 是否为 nil。
第2点的扩容策略无非就是从老的 buckets 搬迁到新的 buckets,由于 bucktes 数量不变,因此可以按序号来搬,比如原来在 0 号 bucktes,到新的地方后,仍然放在 0 号 buckets。
针对第一点的扩容策略涉及到bucket的“裂变”,需要根据低B位重新计算key落在哪个bucket上,这称为rehash。
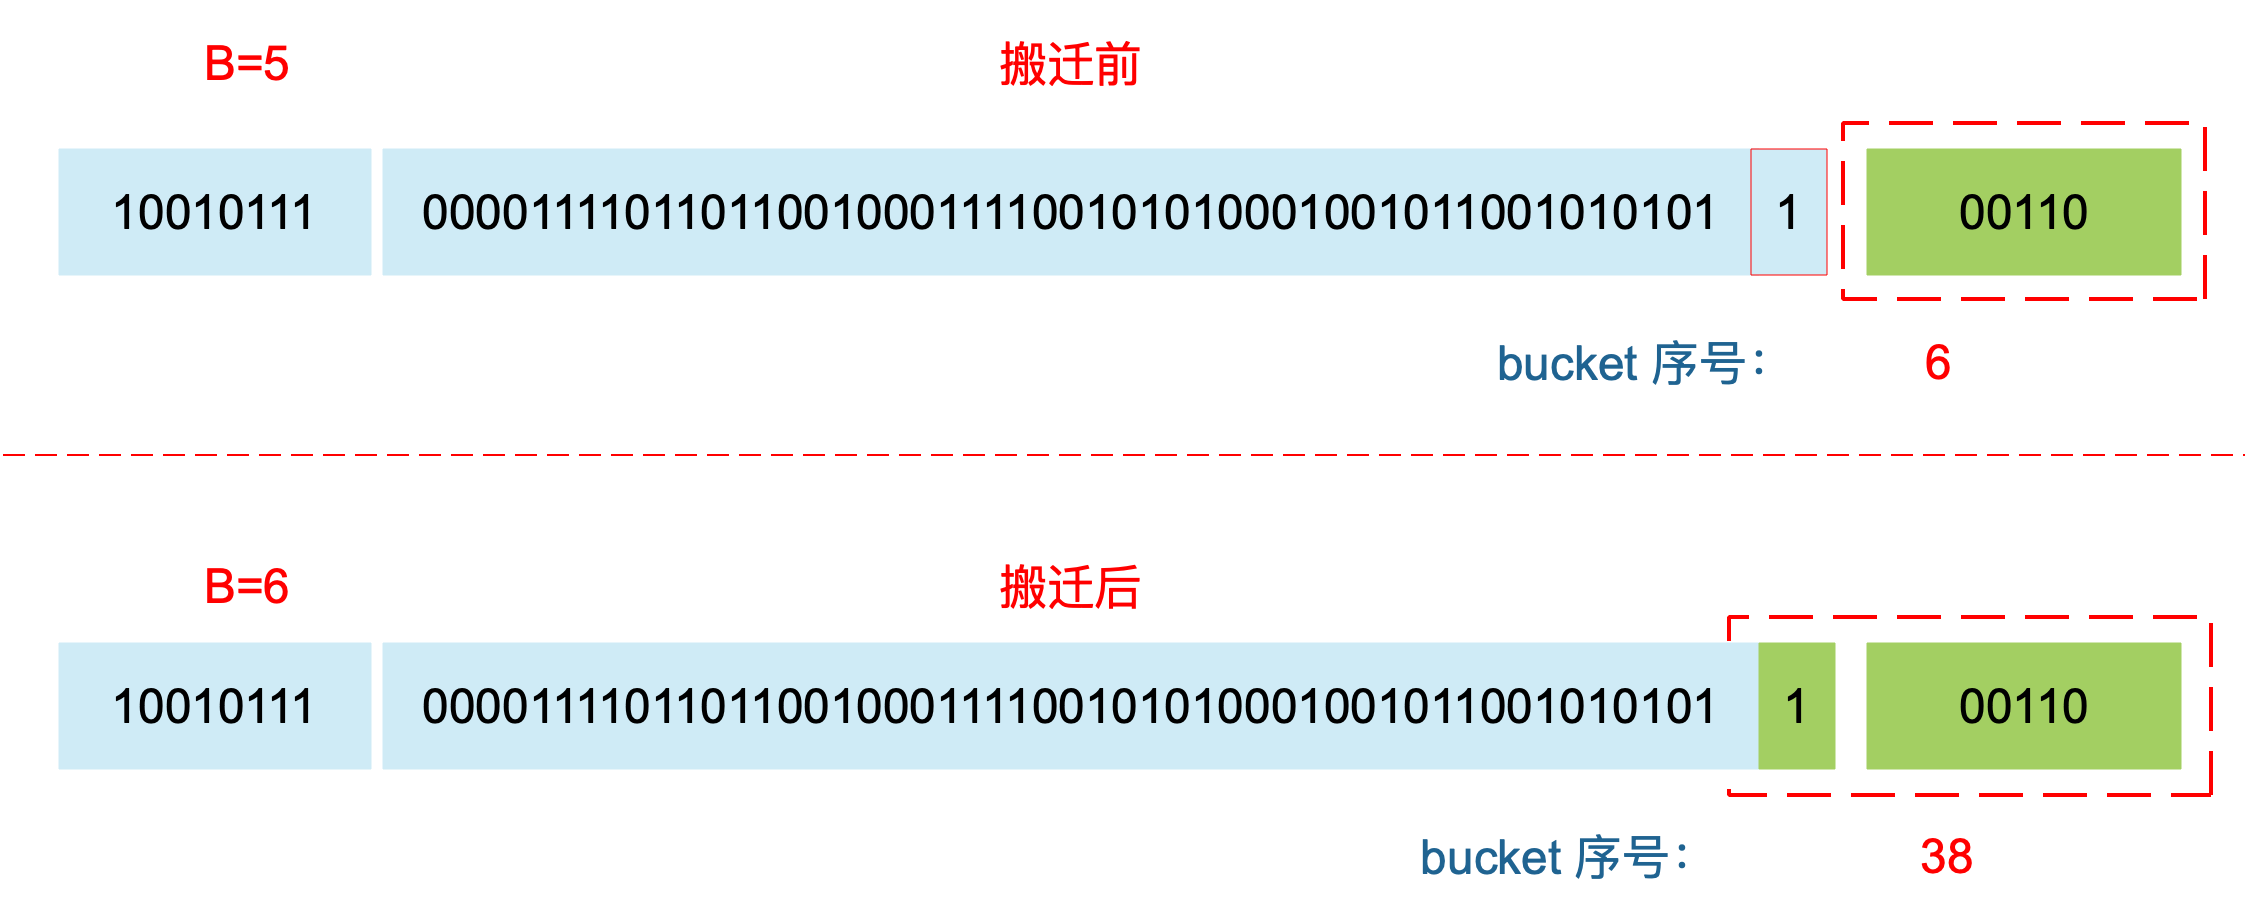 某个 key 在搬迁前后 bucket 序号可能和原来相等,也可能是相比原来加上 2^B(原来的 B 值),取决于 hash 值 第 6 bit 位是 0 还是 1。
再明确一个问题:如果扩容后,B 增加了 1,意味着 buckets 总数是原来的 2 倍,原来 1 号的桶“裂变”到两个桶。
例如,原始 B = 2,1号 bucket 中有 2 个 key 的哈希值低 3 位分别为:010,110。由于原来 B = 2,所以低 2 位 10 决定它们落在 2 号桶,现在 B 变成 3,所以 010、110 分别落入 2、6 号桶。
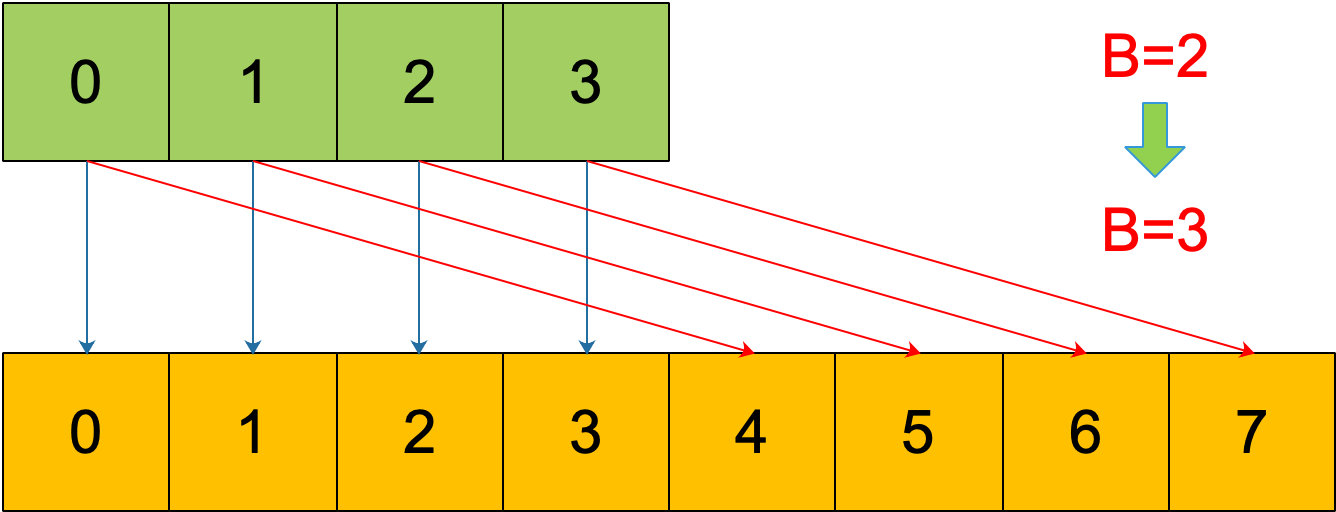
再来看下搬迁过程中的几个关键点:
- evacuate 函数每次只完成一个 bucket 的搬迁工作,因此要遍历完此 bucket 的所有的 cell,将有值的 cell copy 到新的地方。bucket 还会链接 overflow bucket,它们同样需要搬迁。因此会有 2 层循环,外层遍历 bucket 和 overflow bucket,内层遍历 bucket 的所有 cell。
- 源码里提到 X, Y part,其实就是我们说的如果是扩容到原来的 2 倍,桶的数量是原来的 2 倍,前一半桶被称为 X part,后一半桶被称为 Y part。一个 bucket 中的 key 可能会分裂落到 2 个桶,一个位于 X part,一个位于 Y part。所以在搬迁一个 cell 之前,需要知道这个 cell 中的 key 是落到哪个 Part。很简单,重新计算 cell 中 key 的 hash,并向前“多看”一位,决定落入哪个 Part,这个前面也说得很详细了。
有一个特殊情况是:
有一种 key,每次对它计算 hash,得到的结果都不一样。这个 key 就是 math.NaN() 的结果,它的含义是 not a number,类型是 float64。当它作为 map 的 key,在搬迁的时候,会遇到一个问题:再次计算它的哈希值和它当初插入 map 时的计算出来的哈希值不一样!
你可能想到了,这样带来的一个后果是,这个 key 是永远不会被 Get 操作获取的!当我使用 m[math.NaN()] 语句的时候,是查不出来结果的。这个 key 只有在遍历整个 map 的时候,才有机会现身。所以,可以向一个 map 插入任意数量的 math.NaN() 作为 key。
当搬迁碰到 math.NaN() 的 key 时,只通过 tophash 的最低位决定分配到 X part 还是 Y part(如果扩容后是原来 buckets 数量的 2 倍)。如果 tophash 的最低位是 0 ,分配到 X part;如果是 1 ,则分配到 Y part。
Map遍历
Q:「为什么遍历map的key是无序的?」
map 在扩容后,会发生 key 的搬迁,原来落在同一个 bucket 中的 key,搬迁后,有些 key 就要远走高飞了。这样即使遍历的过程是顺序的,在经历扩容后再次遍历后的结果也会变得错乱,和原来的顺序有很大出入。
当然,如果我就一个 hard code 的 map,我也不会向 map 进行插入删除的操作,按理说每次遍历这样的 map 都会返回一个固定顺序的 key/value 序列吧。的确是这样,但是 Go 杜绝了这种做法。
甚至 Go 做得更绝,当我们在遍历 map 时,并不是固定地从 0 号 bucket 开始遍历,每次都是从一个随机值序号的 bucket 开始遍历,并且是从这个 bucket 的一个随机序号的 cell 开始遍历。这样,即使你是一个写死的 map,仅仅只是遍历它,也不太可能会返回一个固定序列的 key/value 对了。
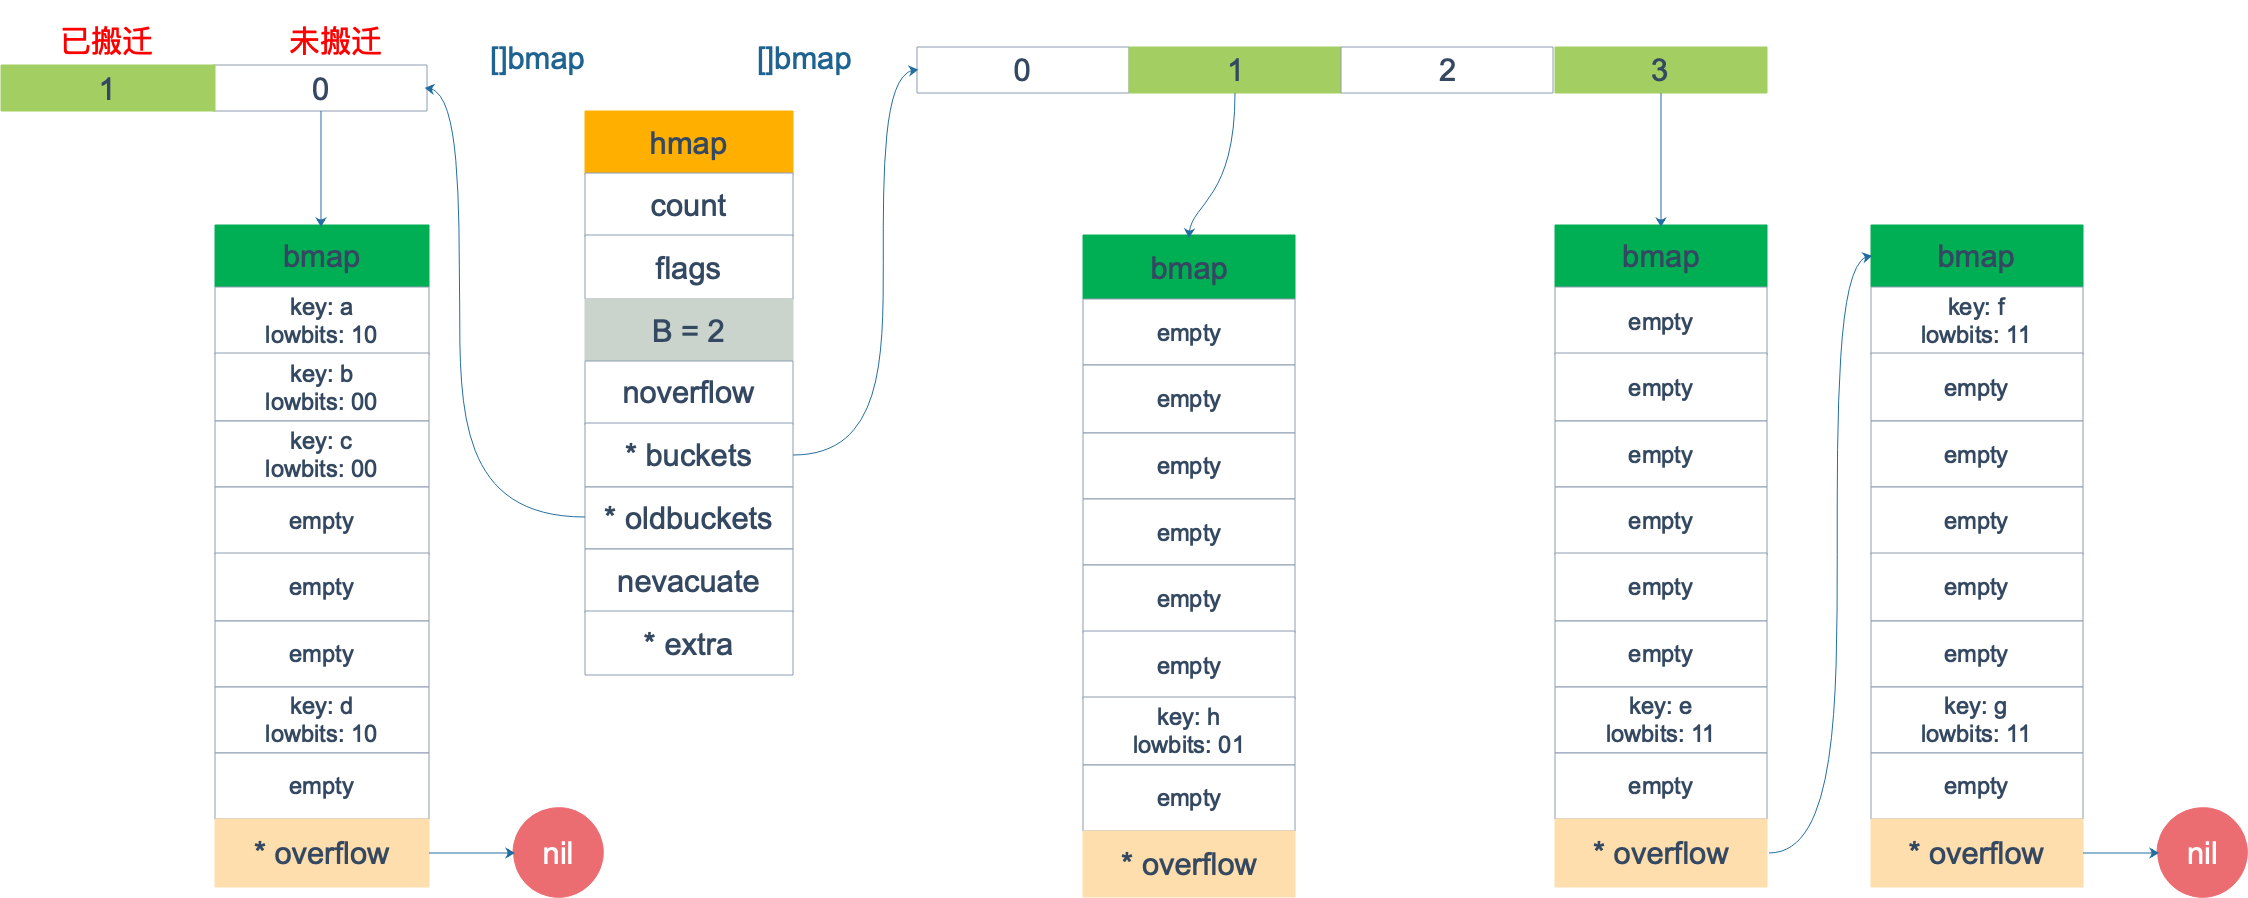
假设我们有下图所示的一个 map,起始时 B = 1,有两个 bucket,后来触发了扩容(这里不要深究扩容条件,只是一个设定),B 变成 2。并且, 1 号 bucket 中的内容搬迁到了新的 bucket,1 号裂变成 1 号和 3 号;0 号 bucket 暂未搬迁。老的 bucket 挂在在 *oldbuckets 指针上面,新的 bucket 则挂在 *buckets 指针上面。
这时,我们对此 map 进行遍历。假设经过初始化后,startBucket = 3,offset = 2。于是,遍历的起点将是 3 号 bucket 的 2 号 cell,下面这张图就是开始遍历时的状态:
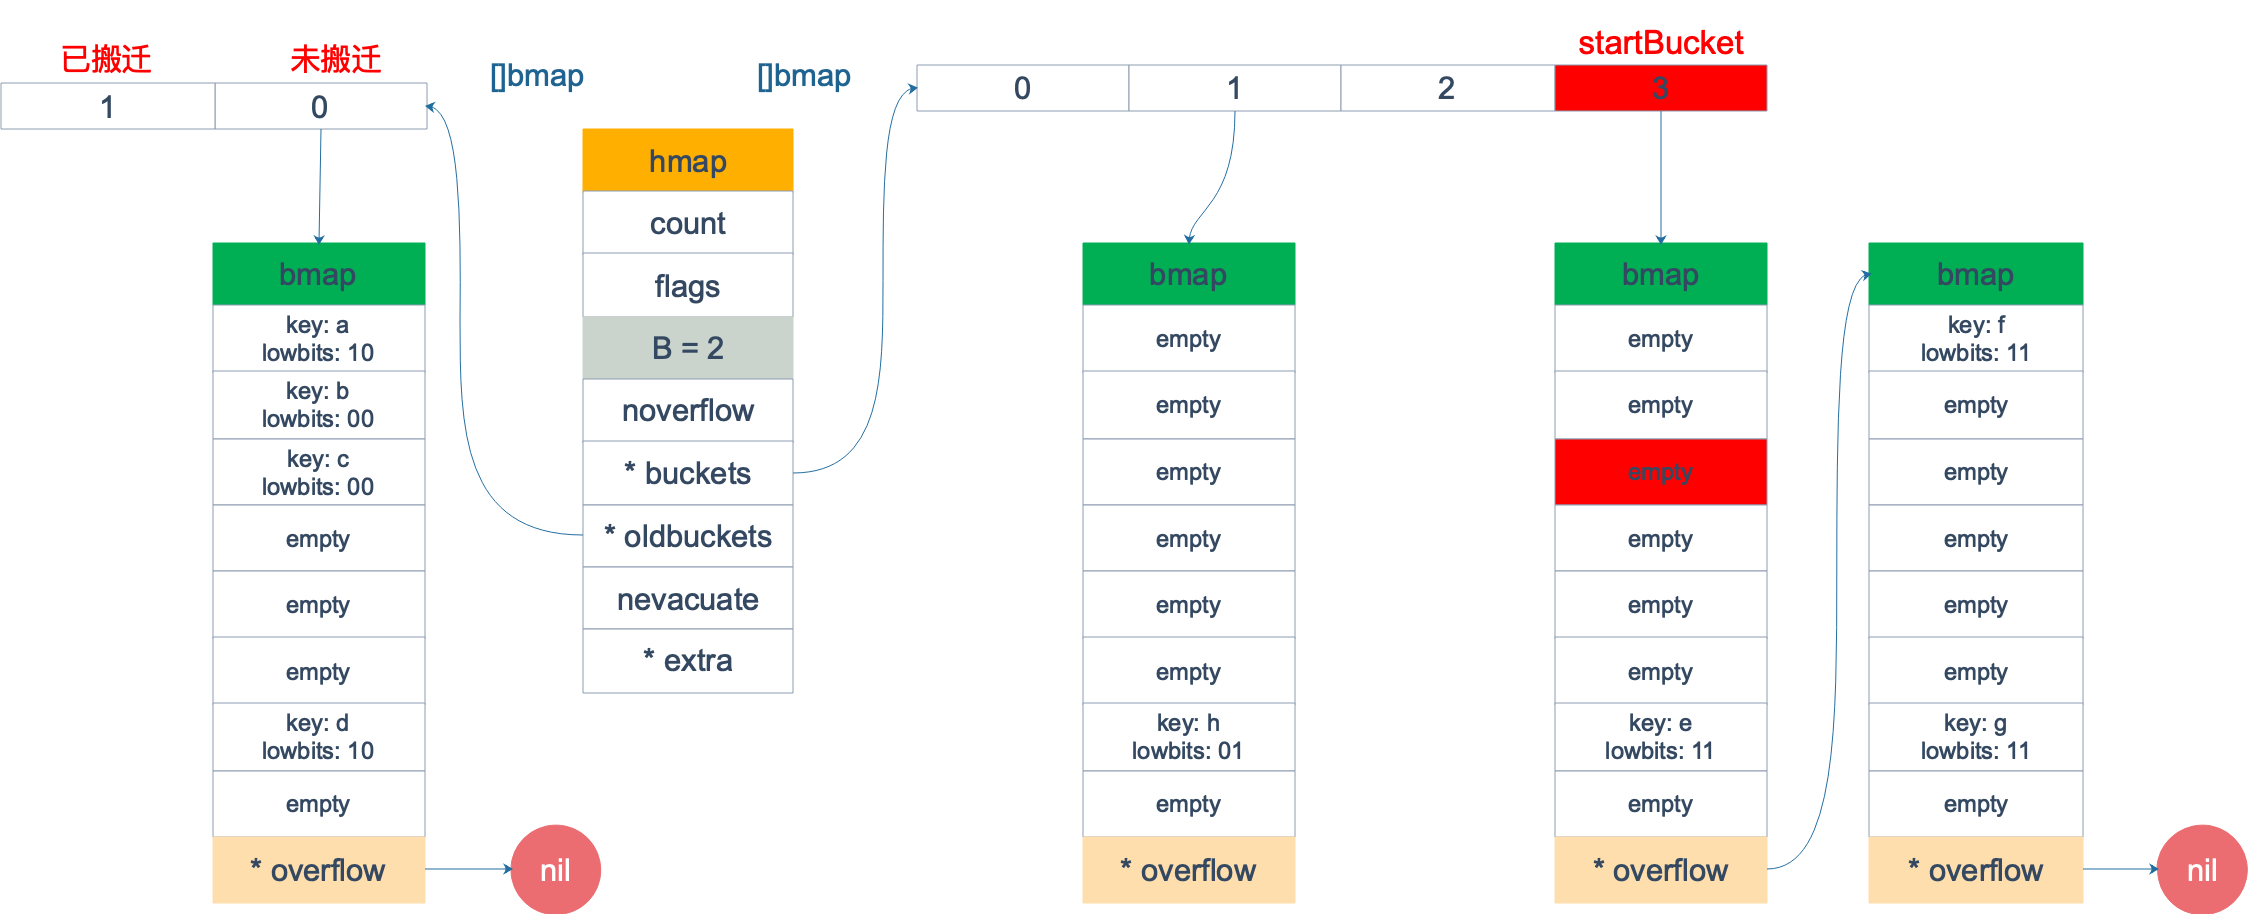
标红的表示起始位置,bucket 遍历顺序为:3 -> 0 -> 1 -> 2。
因为 3 号 bucket 对应老的 1 号 bucket,因此先检查老 1 号 bucket 是否已经被搬迁过。
判断方法就是:
func evacuated(b *bmap) bool {
h := b.tophash[0]
return h > empty && h < minTopHash
}
如果 b.tophash[0] 的值在标志值范围内,即在 (0,4) 区间里,说明已经被搬迁过了。 在本例中,老 1 号 bucket 已经被搬迁过了。所以它的 tophash[0] 值在 (0,4) 范围内,因此只用遍历新的 3 号 bucket。
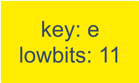
依次遍历 3 号 bucket 的 cell,这时候会找到第一个非空的 key:元素 e。到这里,我们的遍历结果仅有一个元素:
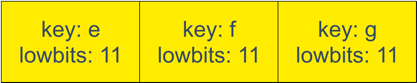
由于返回的 key 不为空,继续从上次遍历到的地方往后遍历,从新 3 号 overflow bucket 中找到了元素 f 和 元素 g。
遍历结果集也因此壮大:
新 3 号 bucket 遍历完之后,回到了新 0 号 bucket。0 号 bucket 对应老的 0 号 bucket,经检查,老 0 号 bucket 并未搬迁,因此对新 0 号 bucket 的遍历就改为遍历老 0 号 bucket。那是不是把老 0 号 bucket 中的所有 key 都取出来呢?
并没有这么简单,回忆一下,老 0 号 bucket 在搬迁后将裂变成 2 个 bucket:新 0 号、新 2 号。而我们此时正在遍历的只是新 0 号 bucket(注意,遍历都是遍历的 *bucket 指针,也就是所谓的新 buckets)。所以,我们只会取出老 0 号 bucket 中那些在裂变之后,分配到新 0 号 bucket 中的那些 key。
因此,lowbits == 00 的将进入遍历结果集:
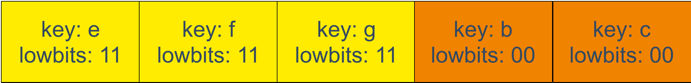
和之前的流程一样,继续遍历新 1 号 bucket,发现老 1 号 bucket 已经搬迁,只用遍历新 1 号 bucket 中现有的元素就可以了。 继续遍历新 2 号 bucket,它来自老 0 号 bucket,因此需要在老 0 号 bucket 中那些会裂变到新 2 号 bucket 中的 key,也就是 lowbit == 10 的那些 key。
这样,遍历结果集变成:
 最后,继续遍历到新 3 号 bucket 时,发现所有的 bucket 都已经遍历完毕,整个迭代过程执行完毕。
Q:「可以边遍历边删除吗?」
map 并不是一个线程安全的数据结构。同时读写一个 map 是未定义的行为,如果被检测到,会直接 panic。
在查找、赋值、遍历、删除的过程中都会检测写标志,一旦发现写标志置位(等于1),则直接 panic。赋值和删除函数在检测完写标志是复位之后,先将写标志位置位,才会进行之后的操作。
上面说的是发生在多个协程同时读写同一个 map 的情况下。 如果在同一个协程内边遍历边删除,并不会检测到同时读写,理论上是可以这样做的。但是,遍历的结果就可能不会是相同的了,有可能结果遍历结果集中包含了删除的 key,也有可能不包含,这取决于删除 key 的时间:是在遍历到 key 所在的 bucket 时刻前或者后。
另外,sync.Map 是线程安全的 map,也可以使用。
其他
两种get操作
// src/runtime/hashmap.go
func mapaccess1(t *maptype, h *hmap, key unsafe.Pointer) unsafe.Pointer
func mapaccess2(t *maptype, h *hmap, key unsafe.Pointer) (unsafe.Pointer, bool)
float类型可以作为map的key吗
A:
可以,但当用 float64 作为 key 时,Go内部会先通过Float64frombits函数将其转成 uint64 类型,再插入 key 中。
此过程可能会造成两个float64不同的值经过处理后映射到了同一个key的问题,慎用之。
func main() {
	m := make(map[float64]int)
	m[1.4] = 1
	m[2.4] = 2
	m[math.NaN()] = 3
	m[math.NaN()] = 3

	for k, v := range m {
		fmt.Printf("[%v, %d] ", k, v)
	}

	fmt.Printf("\nk: %v, v: %d\n", math.NaN(), m[math.NaN()])
	fmt.Printf("k: %v, v: %d\n", 2.400000000001, m[2.400000000001])
	fmt.Printf("k: %v, v: %d\n", 2.4000000000000000000000001, m[2.4000000000000000000000001])

	fmt.Println(math.NaN() == math.NaN())
}

OUTPUT:
[2.4, 2] [NaN, 3] [NaN, 3] [1.4, 1]
k: NaN, v: 0
k: 2.400000000001, v: 0
k: 2.4, v: 2
false
如何比较两个map
A:
使用reflect.DeepEqual函数
package main

import (
	"fmt"
	"reflect"
)

func main() {
	map1 := map[string]int{"a": 1, "b": 2}
	map2 := map[string]int{"a": 1, "b": 2}
	map3 := map[string]int{"a": 1, "b": 3}

	fmt.Println(reflect.DeepEqual(map1, map2)) // true
	fmt.Println(reflect.DeepEqual(map1, map3)) // false
}
map容量为什么是2的幂次?
- 核心原因:位运算替代取模高效计算索引位置
- 扩容时的重新哈希 HashMap 扩容时(如从 16→32),原有元素需要重新计算索引。当容量为 2 的幂次方时,新索引只需判断哈希值的某一位(例如扩容后第 5 位)是 0 还是 1: 若为 0,则新索引 = 原索引; 若为 1,则新索引 = 原索引 + 旧容量。 无需重新计算哈希值,效率极高。
可以对map的元素取地址吗
无法对 map 的 key 或 value 进行取址。
package main

import "fmt"

func main() {
	m := make(map[string]int)

	fmt.Println(&m["qcrao"])
}

// ./main.go:8:14: cannot take the address of m["qcrao"]
如果通过其他 hack 的方式,例如 unsafe.Pointer 等获取到了 key 或 value 的地址,也不能长期持有,因为一旦发生扩容,key 和 value 的位置就会改变,之前保存的地址也就失效了。